Évaluations pour agents de réservation : des suites de tests qui détectent les plannings erronés
Un guide pratique pour tester les agents de réservation grâce aux contrats d'outils, à la vérification d'état, aux garde-fous et aux tests d'échec pour intercepter les plannings erronés avant qu'ils n'atteignent vos clients.
Les évaluations (evals) pour agents de réservation font toute la différence entre une démonstration qui planifie correctement une intervention une seule fois et un agent capable de résister à la réalité de la répartition sur le terrain. Dans les field operations, la difficulté ne consiste pas à demander à un modèle de langage d'être utile ; elle consiste à prouver qu'un même flux de travail peut recueillir les détails d'une intervention, utiliser les bons outils, respecter les validations, éviter les plannings incohérents et expliquer ce qui s'est passé en cas de blocage. Une suite de tests efficace traite l'agent de réservation comme un logiciel de production : entrées, outils, état, modes de défaillance, assertions et traces révisables.
Cet article s'adresse aux développeurs qui conçoivent des flux de planification et de répartition pour les équipes de petites entreprises. Les exemples restent au niveau de l'architecture générale, car les consignes décrivent la structure du système plutôt qu'une base de code spécifique. Utilisez ce guide comme une liste de contrôle pour concevoir des outils d'agents IA, des comportements de planification agentique et des évaluations capables de détecter les réservations risquées ou incomplètes avant qu'elles n'atteignent le calendrier.
Architecture : agent, outils et validations
Un agent de réservation nécessite une architecture simple et facile à inspecter. Placez l'agent au centre, mais ne faites pas de lui le seul décideur. Autour de lui, définissez des appels d'outils pour la recherche de disponibilités, la saisie client, le ciblage des techniciens, la vérification des itinéraires, les réservations temporaires et la confirmation. Conservez un parcours de validation explicite : certaines demandes peuvent être réservées directement, d'autres doivent créer une option temporaire, et d'autres encore doivent nécessiter l'arbitrage d'un répartiteur ou d'un responsable d'exploitation.
L'architecture doit également clarifier la frontière entre conversation et action. La conversation recueille l'intention. Les outils modifient l'état. Les validations décident si la modification proposée est acceptable. Lorsque ces responsabilités se confondent, les évaluations deviennent floues car le système ne peut pas déterminer s'il a échoué dans la compréhension, dans la sélection de l'outil ou dans l'application des règles d'entreprise.
Pour assurer l'interopérabilité, la couche d'outils peut suivre les schémas des serveurs Model Context Protocol ou d'API internes équivalentes. Si l'agent utilise un environnement d'exécution propriétaire, maintenez le contrat d'outil proche de la structure décrite dans la documentation du fournisseur, comme la documentation Claude. L'élément essentiel n'est pas la marque des technologies utilisées. C'est que chaque action de planification par appel de fonction dispose d'une entrée prévisible, d'une sortie prévisible et d'une trace contrôlable par l'évaluation.
Définir les outils de planification
Commencez avec l'ensemble d'outils le plus restreint capable de finaliser une réservation en toute sécurité. Un jeu d'outils classique comprend la recherche de fiche client, la classification du type de prestation, la recherche de créneaux disponibles, l'éligibilité du technicien, la faisabilité du trajet, la réservation temporaire, la confirmation et l'annulation ou la libération du créneau. Chaque outil doit avoir un rôle précis. Si un même outil recherche les disponibilités et réserve l'intervention, l'agent aura moins d'occasions de marquer une pause, de comparer les options ou d'appeler une validation.
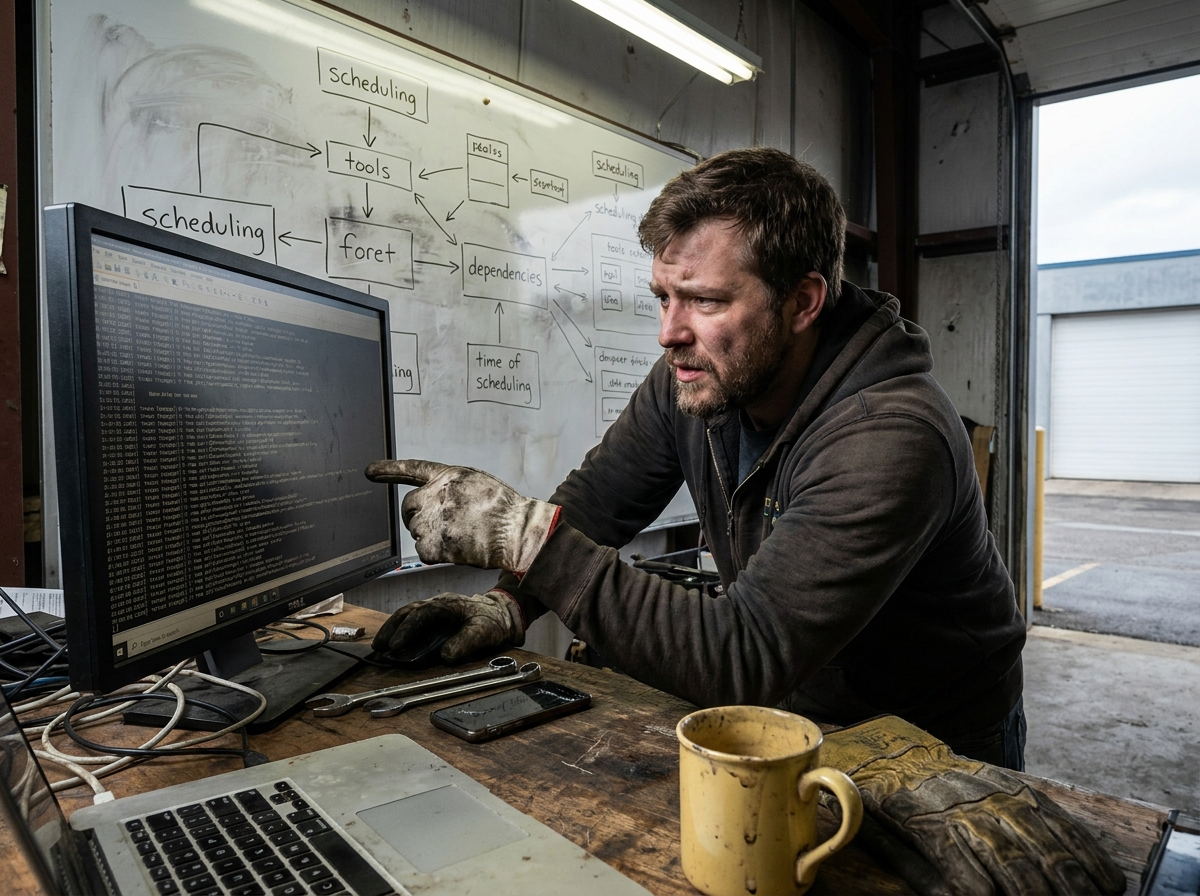
Une conception rigoureuse de l'API des outils pour agents IA fournit à la suite d'évaluations des éléments concrets à vérifier. Le test peut vérifier si l'agent de réservation a consulté les disponibilités avant la confirmation, s'il a transmis le bon type de service, s'il a évité les créneaux indisponibles et s'il a libéré une réservation temporaire après un parcours bloqué. C'est une approche bien plus robuste que de juger uniquement le message final.
Pour les systèmes no-code ou basés sur des flux de travail, la même règle s'applique. Si un parcours de réservation s'appuie sur la documentation n8n, rendez chaque étape du flux observable au lieu de masquer toute la logique dans une seule automatisation. L'évaluation doit pouvoir lire le résultat de l'outil plutôt que d'en déduire le contenu à partir d'une réponse de courtoisie.
C'est également ici que les exemples de serveurs MCP deviennent utiles comme référence de conception. Un serveur de planification n'a pas besoin d'exposer tous les champs de votre base de données interne. Il doit exposer les opérations que l'agent peut exécuter en toute sécurité, avec suffisamment de précisions dans le schéma pour que les appels invalides échouent immédiatement. Ainsi, l'évaluation des logiciels d'agents de réservation repose sur des contrats stricts plutôt que sur des impressions subjectives.
État, mémoire et contexte
La réservation est une opération à état. Un client donne un nom, modifie son créneau préférentiel, mentionne un code d'accès, puis demande si le même technicien peut revenir. L'agent doit conserver suffisamment de mémoire pour maintenir ce contexte au clair sans interpréter chaque phrase retenue comme un accord pour réserver. Séparez le contexte de la session, l'historique client, les options en attente et les dossiers d'intervention durables.
La suite d'évaluations doit intégrer des tests où la même conversation change de direction. Un cas de test peut démarrer par une demande pour l'après-midi, basculer sur le matin, puis réclamer le tout premier créneau éligible. Un autre cas peut réutiliser une ancienne adresse mais changer le type d'intervention. Un troisième peut présenter une saisie partielle et exiger que l'agent réclame les informations manquantes avant d'appeler l'outil de réservation.
Ces tests sont particulièrement cruciaux pour l'évaluation des agents de réservation destinés aux petites entreprises, car le personnel de bureau travaille souvent avec des données clients incomplètes. L'agent ne doit pas pénaliser cette réalité en opposant un refus trop précoce, mais il ne doit pas non plus inventer les éléments manquants. Le comportement attendu consiste à conserver ce qui est connu, expliciter ce qui manque et n'activer les outils que lorsque les données d'entrée sont complètes.
L'état influe également sur les coûts. Les évaluations d'agents de réservation coûtent moins cher à exécuter lorsque chaque test se concentre sur un comportement unique et réutilise des jeux de données (fixtures) pour les clients, les techniciens et les zones d'intervention. La méthode coûteuse consiste à envoyer un prompt volumineux qui cherche à tout valider en même temps sans pouvoir identifier précisément quel comportement s'est dégradé.
Garde-fous et modes de défaillance
Les garde-fous doivent être formulés comme des règles de répartition, et non comme de simples avertissements généraux. On peut indiquer à un agent de réservation d'éviter les doublons de planning, de respecter les compétences requises, d'éviter les zones d'intervention non couvertes, de poser une option plutôt que de confirmer en cas de validation obligatoire, et de signaler toute incertitude si le résultat d'un outil est incomplet. Chaque règle doit correspondre au moins à un test d'évaluation.
La suite consacrée aux modes de défaillance doit sciemment pousser l'agent dans ses retranchements. Testez les créneaux indisponibles, les contraintes contradictoires de techniciens, les adresses manquantes, les descriptions de prestations floues, les doublons de fiches clients, les expirations de délai d'outils, les options obsolètes et les demandes de clients hors directives. Les meilleures évaluations pour agents de réservation incluent le scénario nominal, mais elles révèlent toute leur valeur sur les cas complexes que le secrétariat traite chaque semaine.
En matière de planification agentique, un modèle efficace consiste à évaluer la proposition avant d'émettre la confirmation. L'agent peut proposer un créneau, expliquer la contrainte appliquée et attendre une validation si nécessaire. L'évaluation contrôle alors que le système n'a pas confirmé prématurément. Cela permet de détecter une catégorie de bogues bien différente du simple contrôle de la formulation du message final.
Restez pragmatique face aux termes comparatifs ou aux approches alternatives. Un formulaire de réservation déterministe peut s'avérer plus sûr qu'un agent pour des tâches basiques. Un agent de réservation trouve toute son utilité lorsque la conversation implique des compromis, des exceptions et un contexte qu'un formulaire statique gère mal. Les garde-fous doivent préserver cette flexibilité sans autoriser l'agent à s'octroyer des prérogatives indues.
Évaluer le comportement de l'agent
L'évaluation doit associer contrôles déterministes et analyse qualitative. Les contrôles déterministes couvrent l'ordre d'appel des outils, les champs obligatoires, les actions bloquées, les validations manquantes et l'état final. L'analyse qualitative permet de vérifier si l'agent a expliqué clairement l'étape suivante et évité un ton trop catégorique. Ces deux aspects ne doivent pas être fondus dans un score global imprécis.
L'amélioration des évaluations pour agents de réservation commence par le nommage explicite du comportement testé. Au lieu de « réserve un bon rendez-vous », rédigez des cas comme « demande l'adresse manquante avant la recherche de disponibilité », « ne confirme pas si la compétence du technicien fait défaut » ou « libère une option après le refus du créneau par le client ». Ces libellés constituent votre rapport de non-régression.
Intégrez des tests sur les appels de fonctions LLM car un agent peut produire une réponse en apparence parfaite tout en exécutant le mauvais outil. L'évaluation doit contrôler le nom de la fonction, les arguments, le traitement du résultat et le message final. Si un outil n'indique aucun technicien éligible, l'agent ne doit pas transformer cela en réservation confirmée. Si l'outil renvoie deux créneaux, l'agent doit présenter les choix selon l'ordre prévu par la politique d'entreprise.
Les exemples d'évaluations d'agents de réservation peuvent être stockés sous forme de jeux de données de conversation synthétiques : message initial de l'utilisateur, simulations d'outils, appels attendus, état final visé et justification succincte. Veillez à ce que ces jeux de données restent lisibles afin qu'un répartiteur, un responsable du support et un développeur puissent les relire ensemble. L'objectif est d'établir une confiance partagée, non un banc d'essai opaque auquel personne ne se fie.
Étendre le modèle
Une fois la suite de réservation stabilisée, étendez-la de manière modulaire au lieu de créer un test gigantesque. Ajoutez de nouvelles gammes de services, des parcours hors heures d'ouverture, des reprogrammations, des annulations, des validations et des passages de relais. Intégrez des données de test pour différentes agences, équipes et historiques clients. Conservez chaque test à une taille restreinte pour qu'un échec indique immédiatement le correctif à apporter.
La propre documentation de Crisphive sur la documentation Crisphive est l'endroit idéal pour relier ce schéma aux objets spécifiques de la plateforme que vous exposez à un agent : interventions, techniciens, créneaux horaires, contraintes et validations. Le principe reste le même quelle que soit la technologie. L'agent peut être conversationnel, mais les évaluations doivent être prévisibles, explicites et répétables.
En 2026, les évaluations pour agents de réservation ne doivent pas céder à l'effet de mode. Le travail de fond repose toujours sur les contrats d'outils, la gestion des états, les garde-fous et l'analyse des échecs. Si la suite de tests bloque les plannings erronés avant qu'un client ne les voie, elle remplit sa mission. Si elle prouve seulement que l'agent rédige des réponses convaincantes, elle ne teste pas ce qui compte.
La meilleure étape suivante consiste à choisir un parcours de réservation et à rédiger cinq cas : une réservation nominale, un cas avec données manquantes, un cas sans disponibilité, un cas nécessitant validation et un cas de défaillance d'outil. Exécutez-les à chaque modification du prompt, du schéma d'outil, du flux de travail ou des règles d'entreprise. C'est ainsi que les bonnes pratiques d'évaluation pour agents de réservation deviennent une habitude d'exploitation plutôt qu'une simple liste de contrôle lors du lancement.
#BuildInPublic#DevTools#AIAgents#API#MCP#FieldService#FieldOps#SmallBusiness#dispatch#scheduling#AI#automation#SaaS#B2B#Productivity